LotusDecoder
RT @jtdavies: Qwen4, coming soon…
CTO quote was “next week”
Xudong Guo - Research Scientist, Qwen, Token Foundry
Live from Amsterdam
063020
@LotusDecoder
Focus Personal AI && inner life. 2× DGX Spark · M4 Max 128GB
阑夕 @foxshuo怎么区分一款AI产品是ChatBot还是Personal Agent? 很简单,如果图标长得像屁眼,那就是ChatBot,如果长有一张脸,那就是Personal Agent。

zzxwill @zzxwill知道@yetone 最初是美女+才女前同事跟他做了同事,然后是 Alma,接着是 Magpie,昨天知道他的名字叫叶天帝,今天知道他的名字叫叶为天帝。 做了几个产品,什么时候可以做出 yetone 这样的品质和效果

Herman Brunborg @hermanbrunborgI improved NanoGPT Speedrun from 39.9s → 6.7s (-83.2%), more than every record since 2025 combined (-81.4%)! The web is full of rare, repeated content that the LM can’t memorize in time. I solve this with retrieval-augmented n-gram hints🧵

Herman Brunborg @hermanbrunborgI improved NanoGPT Speedrun from 39.9s → 6.7s (-83.2%), more than every record since 2025 combined (-81.4%)! The web is full of rare, repeated content that the LM can’t memorize in time. I solve this with retrieval-augmented n-gram hints🧵
寒塘poolmoon @poolmoon6说一个很可怕的事情: GPT-5.6出来的时候,大家都惊为天人,而我跟他探讨深度问题,他就是讨论不到点子上,搞得我相当烧心 后来Fable-5出来了,我一下子感觉找到了知音。思考顺畅多了 结果最近跟Fable-5.1探讨问题,又是半天探讨不出来,我一急,让他把问题总结了给Gemini-4-argon,还真的有了突破。,然后再把结论返回给Fable。 不是说模型能力都平台期了很多任务再强的模型已经没必要吗,不是说连数学界计算机界的定理猜想根基都动摇了吗。为什么这些模型还是会卡在我的问题上,莫非真的要: GPT-6-Bel Fable-5.5 Gemini-4-Carbon? 但我怀疑到时候我会有新的瓶颈 人类对于智能的上限一无所知啊 碳硅协同的潜力还远远没被挖掘

Tw93 @HiTw93给关注者比较多的小伙伴一些建议。 假如你以后想做自己的独立产品,那就不太建议你去接商单,一方面这可能是你未来用户不喜欢的点,另一方面会让你感觉还是自媒体来钱快,可能弄独立开发就坚持不下去了。 假如你以后想做更好的自媒体,其实非常辛苦,那非常建议接商单时候认真体验,尽快让用户看到的和你体验的一样,碰到喝事实不吻合的单子果断拒绝,或者帮助甲方一起完善后再发。 因为你平时肯定也会持续发好内容,然后夹一些商单,但是只要一次你的商单效果和用户体验差距很大,你的关注者会认为你在骗他,这样后续你发的更多非商单好内容,很多用户也会认为这可能是商单,非常容易先入为主,索性不看了。 因为我们自己身份也是各种产品的用户,也是关注者,还是被关注者。
LotusDecoder @LotusDecoder隐约预感, AI 去 to C 、to B 、to G 之外,还有 to S。 AI for science 将是很重要的一块。 一个麻雀虽小五脏俱全的个人科研实验室: - nas,私有化个人图书馆、数据集、托管代码仓库 - 本地部署GPU, 私有化专用的算力,强隐私 - 任务调度执行,个人 PC、旧手机、机器臂 - 实时数据采集, 各家 ai search产品,爬虫,居家及随身传感器、手动录入 --- 首要研究的课题之一,举例饮食如何安排往往是: - 周围哪家供应商,干净健康。 - 自身是什么体质,体重、血压、血脂等适合哪些食品和烹饪方法。 - 自身有哪些喜好菜品、擅长制作的菜品。 - 多久买一次菜,每一顿的食谱,做多少份量,等等。 --- 兵马未动粮草先行,这样在个人生活、工作的很多方面,带有“哲人王”的意味,理性周到地考虑并管理、运行一切。 有可能在增强个人精力和状态,以较低的算力成本,把身边的有利资源,精挑细选后给聚集到自身,最终知行合一。


金のニワトリ @gosrum早速 opencode go 版の方で DeepSeek V4.1 Flash-1017を Terminal-Bench-4.0 で評価するぞ! 果たして GLM-5.3 を超えているという話は本当なのか?

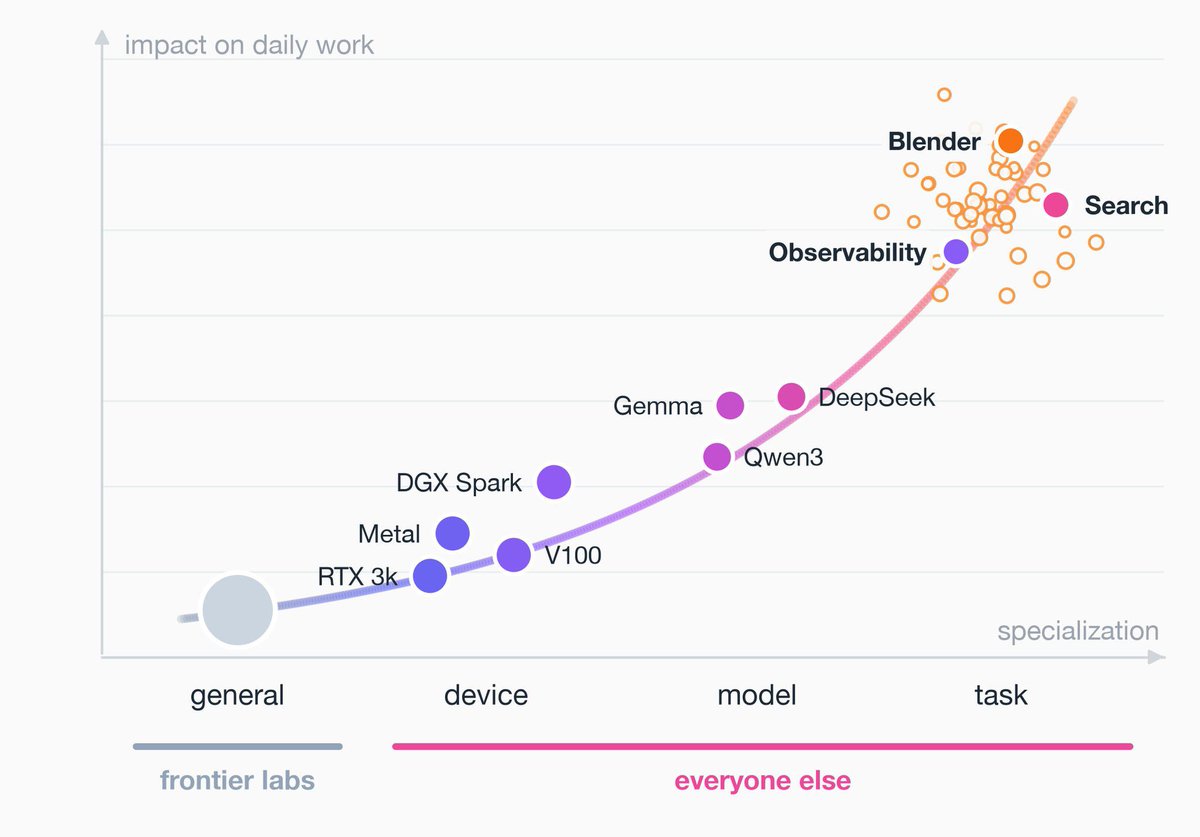
Han Xiao @hxiaoSo after device-specific inference engines (rtx3k, v100, metal) and model-specific inference engines (qwen3/deepseek) we will see more task-specific inference engines emerging soon (like super fast decoding & prefilling on blender task only). I see those adhoc hill climbing as a positive signal showing AI is deeply integrated into daily pedestrian work and cronjobs. One can call them overfitting, but the upside of overfitting is much bigger than its downside for industry. If you are not in frontier lab, overfitting is your friend not your enemy and you should figure out a way to reach overfitting as fast as possible (via RSI etc).
Greg Brockman @gdbAnnouncing three major scientific discoveries, one each in mathematics (harmonic analysis), computer science (complexity theory), and physics (quantum field theory). AI starting to help us improve our understanding of the universe!


限界読書 @genkaidokushoメタ認知に優れている人は、「自分を装置として見ている」と考えています。 自分の仕様、できること/できないこと、適した環境、その結果として生まれる成果。こういった要素を、自分を「別の存在」として認知しながら分析しているのです。 自分はどんな装置なのか?という問いを立てると、メタ認知がしやすくなる。


山景城小路 @Zen_with_AILLM能不能最终推进AGI, 谷歌的 Tom Zahavy写了一篇优美的论文 这是我最近读到最喜欢的论文。 只有7页半,从爱因斯坦,广义相对论,到推理三分法, 到LLM和AGI用非常简明有逻辑的语言把他的观点讲明白了。 小路精读了这篇论文,想带着您一步一步跟随Tom的思维演绎给您。这篇文章没有利用任何AI,也希望您跟着读下来。 爱因斯坦在给终身好友Solovine的信中,提纲挈领的总结了科学发现的流程,从感官经验(E)出发,通过一次直觉的"跳跃"(Jump, J)得到公理系统(A),再从公理演绎出定理(S),最后用实验检验。 也就是 E->J->A->S->E (感官经验->跳跃->公理->演绎出定理->实验) Tom认为,LLM可以做到归纳,也就是统计模式匹配。正在攻克演绎 也就是上文的S. 也可以帮助科学家实现从 S->E。 但是从 E->J->A这个环节,跳跃还是无法实现。 然后 Tom 举了爱因斯坦广义相对论诞生的例子: 1. 经验。 十九世纪末,迈克尔逊-莫雷实验让以太假说失效。牛顿引力则极其精确,惯性质量与引力质量之比验证到 10⁻⁹ 的精度。唯一的异常是水星近日点进动,当时的主流解释是还有一颗未发现的行星"祝融星"。牛顿理论并没有出现危机。 2. 跳跃。 1907 年起,爱因斯坦想象一个自由下落的人:他感受不到引力,可以认为自己静止。这就是"最快乐的想法",即加速与引力等效。这一步不是从数据里归纳出来的,而是靠模拟观察者的身体感受得到的,论文称之为"操作性溯因"。 3. 公理。 1912–1913 年,他与 Grossmann 合作,把物理要求整理成七条原则,包括等效原理、测地线原理、"引力也有引力"和牛顿极限。 4. 演绎。 此后是漫长的数学搜索。他们找到了黎曼曲率张量,却因误以为它不满足牛顿极限而放弃,这个错误出在对静态场的假设上,而不是几何本身。1915 年 11 月,爱因斯坦终于得到场方程,并用它算出了水星进动。 5. 检验。 星光偏折由 Eddington 在数年后测得,GPS 修正更晚。验证证据全部出现在理论之后。 Tom的观点是,演绎只是整个循环的下游环节。如果把爱因斯坦 1915 年的假设交给 LLM,它有可能推出广义相对论,包括水星进动,也可能系统地剔除那个错误的约束。AlphaProof 在 IMO 上的表现,以及 Lean 等证明助手的成熟,都支持这种判断。 但是演绎的局限性是, 1.它只能展开公理的后果。 它既不能生成公理,也不能提供外部验证。 2. 它缺少意图. 换句话说,AI 擅长的是"别人出好题,它来解"。但科学发现更像是自己决定出什么题,还要在没人告诉你对不对的情况下往前走。这是论文说的"意图":不只是会推理,还要知道想要什么。 这个听起来简单,但是实际上,我们和AI合作的过程中也有体会。 问正确的问题,给准确的目标,其实是LLM本身最欠缺的。尤其是在前沿研究领域。没有其他文献可以查询,如何实现这个跳跃? 另外,LLM可以在既有符号空间内更高效地重组概念。甚至可以进行视觉和世界模型预测。但是基于模型的模拟,不等于真是交互模拟。真正的跳跃也往往收到虚拟模型的限制。 简单总结一下就是,Tom认为AI Scientist 是在重组既有符号概念,AlphaEvolve 依赖梯度,在固定框架内优化。关键瓶颈是 E→A 的直觉跳跃,应走向能感知物理世界、运行反事实模拟的世界模型。