🔥牛逼了!12GB显卡本地跑763B!DeepSeek-V4.1-Flash-1017量化版炸裂登场,前沿质量几乎零损失!
ISTA-DASLab团队发布GSQ-RCO非均匀量化版,Strata引擎原生支持。763B参数MoE大模型最低压到1.75 bpw,在消费级硬件上就能跑!
核心亮点
🔹极致压缩 + 几乎无损:IQ2_XXS(2.00 bpw,约249GB)在AIME25、GPQA-Diamond、LiveCodeBench v6上100%恢复原始模型分数;IQ1_M(1.75 bpw,约231GB)整体恢复98.7%。
🔹真正本地可行:单张12GB显卡 + 46-64GB系统内存即可运行,Engram表(约111GB)直接SSD内存映射,无需全部装进内存/显存。
🔹推理速度可玩:RTX 3060上IQ2_XXS约8-10 tok/s;更高端卡更快。原生OpenAI兼容API,支持推理effort调节。
🔹技术硬核:GSQ(Gumbel-Softmax量化)+ RCO(黎曼约束优化)联合,非均匀分配每个tensor的量化类型,远超普通均匀量化。
快速上手步骤
1️⃣一键安装Strata(Windows/Linux脚本或安装包):
curl -fsSL | sh(Linux/Mac)
2️⃣启动并自动下载模型:
strata launch --model ist-das-2.00bpw(推荐2.00 bpw;或ist-das-1.75bpw / ist-das-2.25bpw)
3️⃣等待下载完成(首次需约240-270GB空间,SSD优先),引擎会自动启动本地服务。
4️⃣直接调用:http://127.0.0.1:8080/v1(OpenAI格式)或用配套桌面端/终端交互。
5️⃣高级用户可手动下载GGUF后指定路径:
这是本地AI的又一次质变——763B级别模型从服务器走进游戏本/工作站。
Strata引擎:
#DeepSeek #LocalAI #GSQ #RCO #Strata #开源大模型 #消费级AI #MoE #量化革命


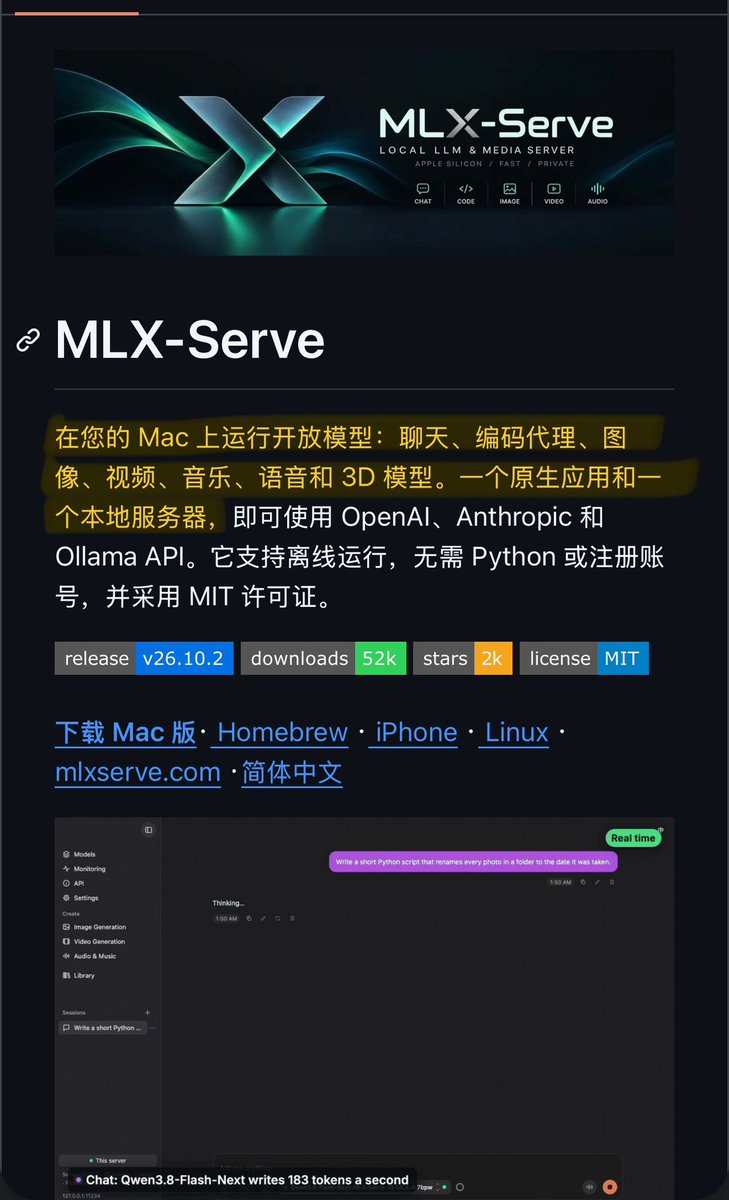
SuSu_酥酥👅 @NFT_Chen💥苹果党码住!只需一台Mac把 DeepSeek-V4.1-Flash 1017 直接干到每秒100+ token! 在单台M5 Ultra,80核GPU + 256GB上,用mlx-serve把刚发布的DeepSeek-V4.1-Flash-1017跑通 核心亮点: 🔹生成速度稳定102~112 tok/s,峰值冲到136.7 tok/s 🔹Prefill读prompt飙到1770 tok/s 🔹短问题首字约0.5秒,16k长上下文约9秒出字 🔹3-bit量化(iQ-MLX-3.0bpw),token匹配率89.8%,困惑度仅+3.6% 🔹自带DSpark草稿层 + prompt lookup加速,跑coding agent尤其猛 快速上手(256GB M5 Ultra用户最划算): 1️⃣升级到macOS 26.10.3预发布版 2️⃣下载MLX-Serve App(或brew安装) 3️⃣打开App,Model Browser搜索DeepSeek-V4.1-Flash下载对应quant 4️⃣直接聊天 / 用Claude Code、Codex等工具连本地端口(兼容OpenAI/Anthropic/Ollama) 完全本地、无需Python、MIT开源,写代码/跑agent神器。 #DeepSeekV41Flash1017 #Mac #LocalAI #MLX #AppleSilicon #M5Ultra #AI #开源 #本地部署 #苹果电脑
631901.8K168K